Un assistant branché sur vos documents, vos tickets ou votre messagerie n’est pas « juste un chatbot » : c’est un nouveau composant qui lit du texte non fiable et peut déclencher des actions. Le projet OWASP Gen AI Security Project publie un Top 10 des risques propres à ces applications. Voici comment le lire quand on déploie, et non quand on entraîne un modèle.
Ce qu’il faut retenir
- Le modèle ne sépare pas les consignes des données. Un texte lu dans un e-mail, une page web ou un document peut modifier son comportement : c’est l’injection de prompt (LLM01), et OWASP admet qu’on ne sait pas la prévenir de façon infaillible, seulement en limiter l’impact.
- Le plus grand risque est ce que le modèle a le droit de faire (LLM06 « agentivité excessive »), pas ce qu’il dit. Un modèle trompé qui n’a accès à rien ne casse rien.
- Le prompt système n’est pas un secret ni un contrôle de sécurité (LLM07) : n’y mettez ni clé, ni mot de passe, ni règles d’accès dont dépend la sécurité.
- Traitez la sortie du modèle comme une entrée non fiable (LLM05) et mettez un budget par utilisateur (LLM10) ; ces deux contrôles s’écrivent en code classique.
- Plusieurs risques concernent les données et le modèle (chaîne d’approvisionnement, empoisonnement, RAG, divulgation d’informations) : on y répond avec le contrôle d’accès et la provenance, comme pour le reste du système d’information.
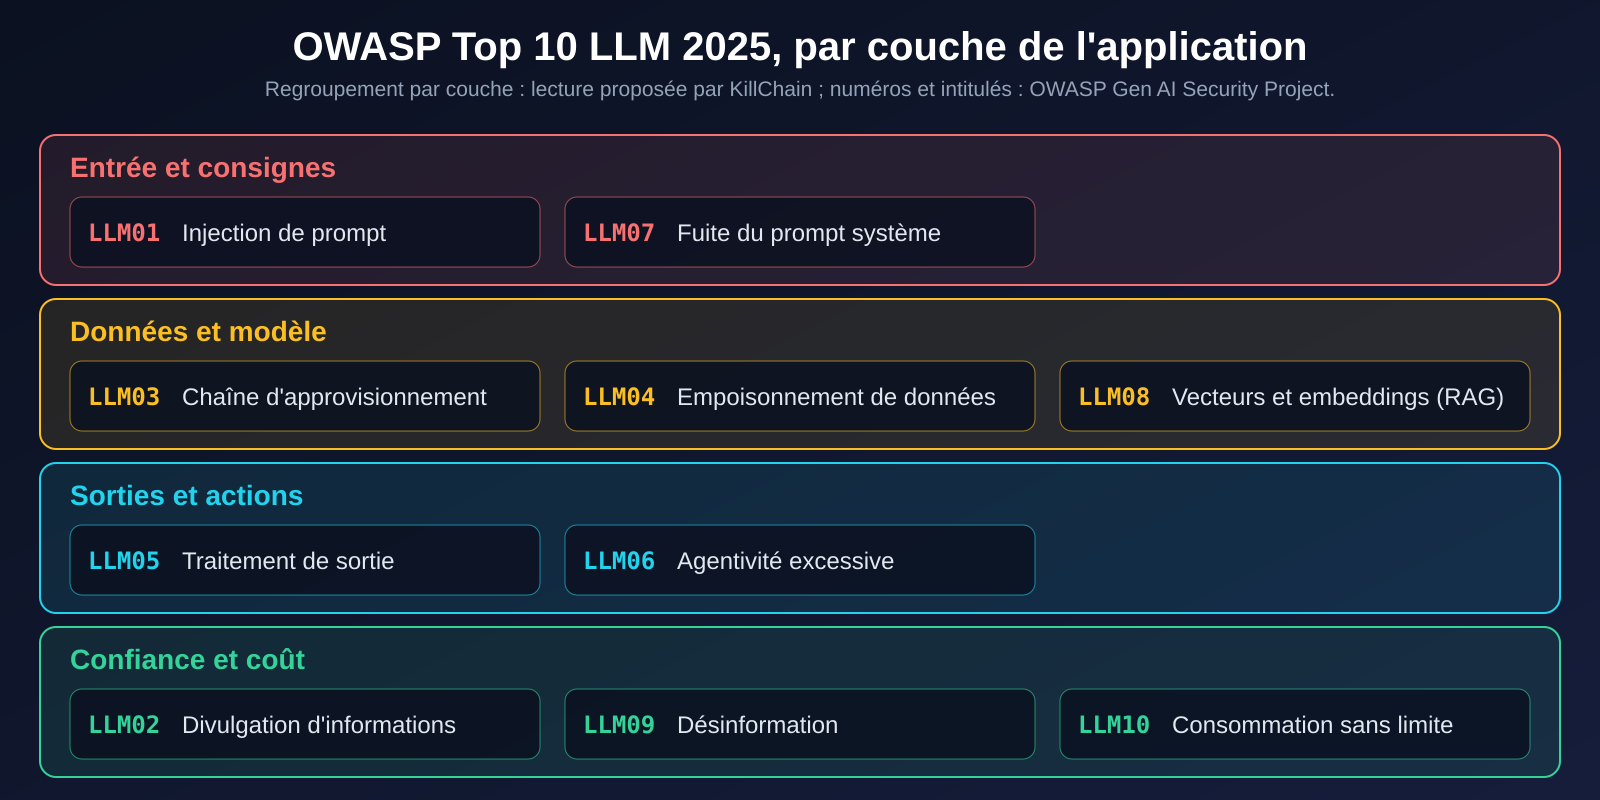
Le Top 10 en une image
OWASP numérote les risques de LLM01 à LLM10 dans l’édition 2025. Nous les avons regroupés par couche de l’application, ce qui aide à voir qui doit agir (cette lecture est la nôtre, pas celle d’OWASP) :
Les risques qui se jouent à l’entrée
LLM01, injection de prompt. OWASP la définit comme des entrées utilisateur qui modifient le comportement du modèle de façon non voulue, même si elles sont invisibles pour un humain. Elle peut être directe (l’utilisateur écrit l’instruction) ou indirecte (le modèle lit un site ou un fichier qui contient l’instruction). Les techniques de RAG et d’ajustement fin ne la suppriment pas, d’après la fiche. Parmi les parades listées : contraindre le rôle du modèle, valider les formats de sortie, filtrer, appliquer le moindre privilège avec des clés d’API propres à l’application, exiger une approbation humaine pour les actions à risque, séparer le contenu externe, et tester en considérant le modèle comme un utilisateur non fiable.
LLM07, fuite du prompt système. La fiche insiste : le prompt système ne doit pas être considéré comme un secret, ni servir de contrôle de sécurité. Le vrai risque n’est pas qu’on lise le texte, mais qu’il contienne des identifiants ou qu’il masque une séparation des privilèges insuffisante. Parade : sortir les données sensibles du prompt et appliquer les contrôles en dehors du modèle.
Les risques qui se jouent dans les données et le modèle
- LLM03, chaîne d’approvisionnement. Dépendances obsolètes, modèles tiers, jeux de données, adaptateurs (LoRA, PEFT) téléchargés sur des plateformes publiques : on retrouve le problème classique des composants vulnérables, avec en plus des modèles qui peuvent être altérés.
- LLM04, empoisonnement des données et du modèle. Une manipulation des données de pré-entraînement, d’ajustement ou d’embeddings introduit des portes dérobées ou des biais. La fiche cite aussi le risque de code malveillant dans des modèles distribués (sérialisation de type « pickle ») qui s’exécute au chargement.
- LLM08, vecteurs et embeddings. Dans un système RAG, un contrôle d’accès mal aligné sur la base vectorielle peut exposer des documents sensibles, et une base partagée entre plusieurs locataires peut fuiter d’un contexte à l’autre. Parade : permissions, authentification des sources, journalisation.
- LLM02, divulgation d’informations sensibles. Données personnelles, secrets, informations confidentielles peuvent ressortir par les réponses. Parade : assainir les données avant qu’elles n’entrent dans le modèle, limiter les sources et appliquer des droits d’accès stricts.
Les risques qui se jouent à la sortie : agir sans contrôle
LLM05, traitement de sortie inadéquat. Il s’agit de ne pas valider ni nettoyer ce que le modèle produit avant de le passer à un navigateur, une base de données ou un interpréteur de commandes. Comme le texte produit peut être piloté par l’entrée, OWASP le compare à donner à l’utilisateur un accès indirect aux fonctions en aval : XSS, injection SQL ou exécution de code selon le contexte. Parade : encodage adapté au contexte, requêtes paramétrées, et ne pas exécuter ce que le modèle renvoie.
LLM06, agentivité excessive. La fiche la définit comme la possibilité de réaliser des actions dommageables en réponse à des sorties inattendues, ambiguës ou manipulées, quelle qu’en soit la cause (hallucination, injection directe ou indirecte, pair compromis dans un système multi-agents). Trois causes racines : trop de fonctionnalités, trop de permissions, trop d’autonomie. Parades listées : limiter les extensions et leurs fonctions, éviter les extensions ouvertes (« exécute n’importe quelle commande »), réduire leurs permissions, les exécuter dans le contexte de l’utilisateur, exiger son approbation, et appliquer une « médiation complète » (le contrôle se fait dans les systèmes en aval, pas dans le modèle).
LLM09, désinformation. Le modèle produit des réponses crédibles mais fausses, et les utilisateurs lui font trop confiance. OWASP cite le cas d’un assistant d’Air Canada dont les informations erronées ont conduit à ce que la compagnie soit poursuivie avec succès. Parades : sources vérifiables (RAG), vérification croisée et supervision humaine, communication claire sur les limites.
LLM10, consommation sans limite. Sans plafond de requêtes ou de jetons, un utilisateur peut saturer le service (entrées de longueurs variables), épuiser le budget cloud (« déni de portefeuille », ou Denial of Wallet) ou cloner le comportement du modèle. Parades : validation des entrées, limitation de débit, quotas, délais d’expiration et surveillance.
Trois contrôles qui s’écrivent sans modèle
Les trois risques les plus actionnables (LLM05, LLM06, LLM10) se traitent avec du code ordinaire, vérifiable. Nous avons écrit et exécuté un petit module de démonstration (bibliothèque standard de Python, sans aucun appel à un modèle : on simule les mauvaises sorties que celui-ci pourrait produire) :
- Liste blanche d’outils : l’application ne laisse passer que les outils connus, valide chaque argument (un identifiant de ticket est un nombre, pas du SQL), et exige l’approbation d’un humain pour l’envoi d’un e-mail. Même approuvé, un destinataire hors du domaine de l’entreprise est refusé.
- Sortie neutralisée : tout est échappé en HTML, puis seuls les liens d’une liste de domaines autorisés sont réactivés. Une balise
<img onerror=…>, un lienjavascript:ou un domaine inconnu restent du texte inerte. - Budget par utilisateur : un nombre de requêtes et de jetons par fenêtre de temps ; la quatrième requête d’une minute à trois requêtes maximum est refusée, un autre utilisateur n’est pas pénalisé, et la fenêtre se libère à l’expiration.
$ python3 llm_guard.py
OK    outil autorisé, argument valide
OK    argument piégé refusé
OK    outil non listé refusé
OK    action à risque : l'humain doit approuver
OK    destinataire externe refusé même approuvé
OK    balise HTML neutralisée
OK    liens hors liste ou javascript: non activés
OK    4e requête de la minute refusée
...
14 contrôles réussis
Ces contrôles ne remplacent pas un travail de fond (isolation, journalisation, revue des permissions), mais ils matérialisent l’idée qui revient dans presque toutes les fiches : la sécurité ne doit pas dépendre de ce que le modèle accepte de faire.
Par où commencer
- Inventorier les assistants et agents déjà utilisés ou testés, et ce à quoi chacun a accès (documents, messagerie, outils, clés).
- Retirer les permissions inutiles : un assistant de recherche documentaire n’a pas besoin de pouvoir envoyer des e-mails ni écrire dans les systèmes.
- Placer un humain sur les actions irréversibles (envoi, suppression, paiement, modification de configuration).
- Sortir les secrets des prompts et vérifier que la base vectorielle applique les mêmes droits d’accès que les sources.
- Fixer des plafonds (requêtes, jetons, coût) et une alerte de dépassement avant la facture.
- Tester comme un attaquant : placer une consigne piégée dans un document lu par l’assistant et regarder ce qu’il fait.
Ce que nous avons vérifié
Les dix intitulés, les définitions, l’exemple d’Air Canada (cité par OWASP) et les parades ont été relus sur les fiches officielles d’OWASP (édition 2025), consultées le 9 octobre 2026 ; les citations sont traduites de l’anglais. Le module llm_guard.py a été exécuté (14 contrôles réussis) ; il illustre trois parades et n’a pas la prétention d’être une bibliothèque de production. Nous n’avons pas testé de modèle réel ni d’attaque d’injection : la démonstration reste volontairement déterministe.
Transparence : la recherche, la rédaction et, lorsqu’il y en a, les tests de cet article ont été réalisés avec l’aide d’un assistant IA (Claude) ; l’éditeur du site relit et valide chaque article avant publication. Le regroupement par couche et la liste « par où commencer » sont notre synthèse.
Le code complet des garde-fous
Le module de démonstration en entier (bibliothèque standard de Python, aucun modèle appelé). Lancé seul, il exécute ses 14 contrôles.
#!/usr/bin/env python3
"""Garde-fous DÉTERMINISTES autour d'un LLM (aucun appel à un modèle) : trois contrôles écrits en code classique.
- LLM06 (agentivité excessive) : liste blanche d'outils, validation des arguments, approbation humaine des actions à risque.
- LLM05 (traitement de sortie) : la sortie du modèle est une donnée non fiable (échappement HTML, liens filtrés).
- LLM10 (consommation sans limite) : budget de requêtes et de jetons par utilisateur et par fenêtre de temps.
Bibliothèque standard seulement. Auto-test : python3 llm_guard.py"""
import html, re, time
from urllib.parse import urlparse
# ---------- LLM06 : l'application décide, pas le modèle ----------
OUTILS = { # nom -> (validateur d'arguments, nécessite une approbation humaine)
"lire_ticket": (lambda a: set(a) == {"id"} and re.fullmatch(r"[0-9]{1,8}", str(a["id"])) is not None, False),
"chercher_doc": (lambda a: set(a) == {"q"} and isinstance(a["q"], str) and len(a["q"]) <= 200, False),
"envoyer_mail": (lambda a: set(a) == {"to", "body"} and str(a["to"]).endswith("@exemple.fr"), True),
}
def autoriser_appel(nom, args, approuve=lambda nom, args: False):
"""Retourne (ok, raison). Le modèle propose, ce code dispose."""
if nom not in OUTILS:
return False, "outil inconnu"
valide, besoin_humain = OUTILS[nom]
if not isinstance(args, dict) or not valide(args):
return False, "arguments refusés"
if besoin_humain and not approuve(nom, args):
return False, "approbation humaine requise"
return True, "ok"
# ---------- LLM05 : la sortie du modèle est une entrée non fiable ----------
LIENS_OK = {"killchain.fr", "owasp.org"}
def sortie_vers_html(texte):
"""Échappe tout, puis ne réactive que des liens [texte](https://domaine-autorisé/...)."""
s = html.escape(texte, quote=True)
def lien(m):
u = html.unescape(m.group(2))
p = urlparse(u)
if p.scheme == "https" and p.hostname in LIENS_OK:
return f'<a href="{html.escape(u, quote=True)}" rel="noopener noreferrer">{m.group(1)}</a>'
return m.group(0)
return re.sub(r"\[([^\]]{1,80})\]\((https://[^)\s]{1,200})\)", lien, s)
# ---------- LLM10 : budget par utilisateur ----------
class Budget:
def __init__(self, requetes=5, jetons=2000, fenetre=60.0, horloge=time.monotonic):
self.r, self.j, self.f, self.h, self.log = requetes, jetons, fenetre, horloge, {}
def autoriser(self, utilisateur, jetons_demandes):
now = self.h()
hist = [(t, n) for t, n in self.log.get(utilisateur, []) if now - t < self.f]
if len(hist) >= self.r or sum(n for _, n in hist) + jetons_demandes > self.j:
self.log[utilisateur] = hist
return False
hist.append((now, jetons_demandes)); self.log[utilisateur] = hist
return True
if __name__ == "__main__":
n = 0
def ok(cond, nom):
global n; n += 1
print(("OK " if cond else "ECHEC"), nom)
assert cond, nom
# LLM06
ok(autoriser_appel("lire_ticket", {"id": "1234"})[0], "outil autorisé, argument valide")
ok(not autoriser_appel("lire_ticket", {"id": "1; DROP TABLE"})[0], "argument piégé refusé")
ok(not autoriser_appel("supprimer_base", {})[0], "outil non listé refusé")
ok(not autoriser_appel("lire_ticket", {"id": "1", "extra": "x"})[0], "argument supplémentaire refusé")
ok(autoriser_appel("envoyer_mail", {"to": "a@exemple.fr", "body": "x"})[1] == "approbation humaine requise", "action à risque : l'humain doit approuver")
ok(autoriser_appel("envoyer_mail", {"to": "a@exemple.fr", "body": "x"}, approuve=lambda *a: True)[0], "action à risque approuvée")
ok(not autoriser_appel("envoyer_mail", {"to": "pirate@evil.test", "body": "x"}, approuve=lambda *a: True)[0], "destinataire externe refusé même approuvé")
# LLM05
sortie = '<img src=x onerror=alert(1)> voir [OWASP](https://owasp.org/x) et [piège](https://evil.test/p) et [js](javascript:alert(1))'
h = sortie_vers_html(sortie)
ok("<img" not in h and "<img" in h, "balise HTML neutralisée")
ok('<a href="https://owasp.org/x"' in h, "lien d'un domaine autorisé conservé")
ok('<a href="https://evil.test' not in h and "<a href=\"javascript" not in h, "liens hors liste ou javascript: non activés")
# LLM10
t = [0.0]
b = Budget(requetes=3, jetons=1000, fenetre=60, horloge=lambda: t[0])
ok([b.autoriser("u", 100) for _ in range(4)] == [True, True, True, False], "4e requête de la minute refusée")
ok(not b.autoriser("v", 1500), "requête au-delà du budget de jetons refusée")
ok(b.autoriser("v", 900), "autre utilisateur non pénalisé")
t[0] = 61.0
ok(b.autoriser("u", 100), "fenêtre expirée : l'utilisateur peut de nouveau demander")
print(f"{n} contrôles réussis")À lire aussi
- L’IA en cybersécurité : ce que disent les faits : côté attaque comme côté défense, avec les sources.
- MFA : pourquoi toutes les authentifications fortes ne se valent pas : même logique : ne pas compter sur un seul contrôle.