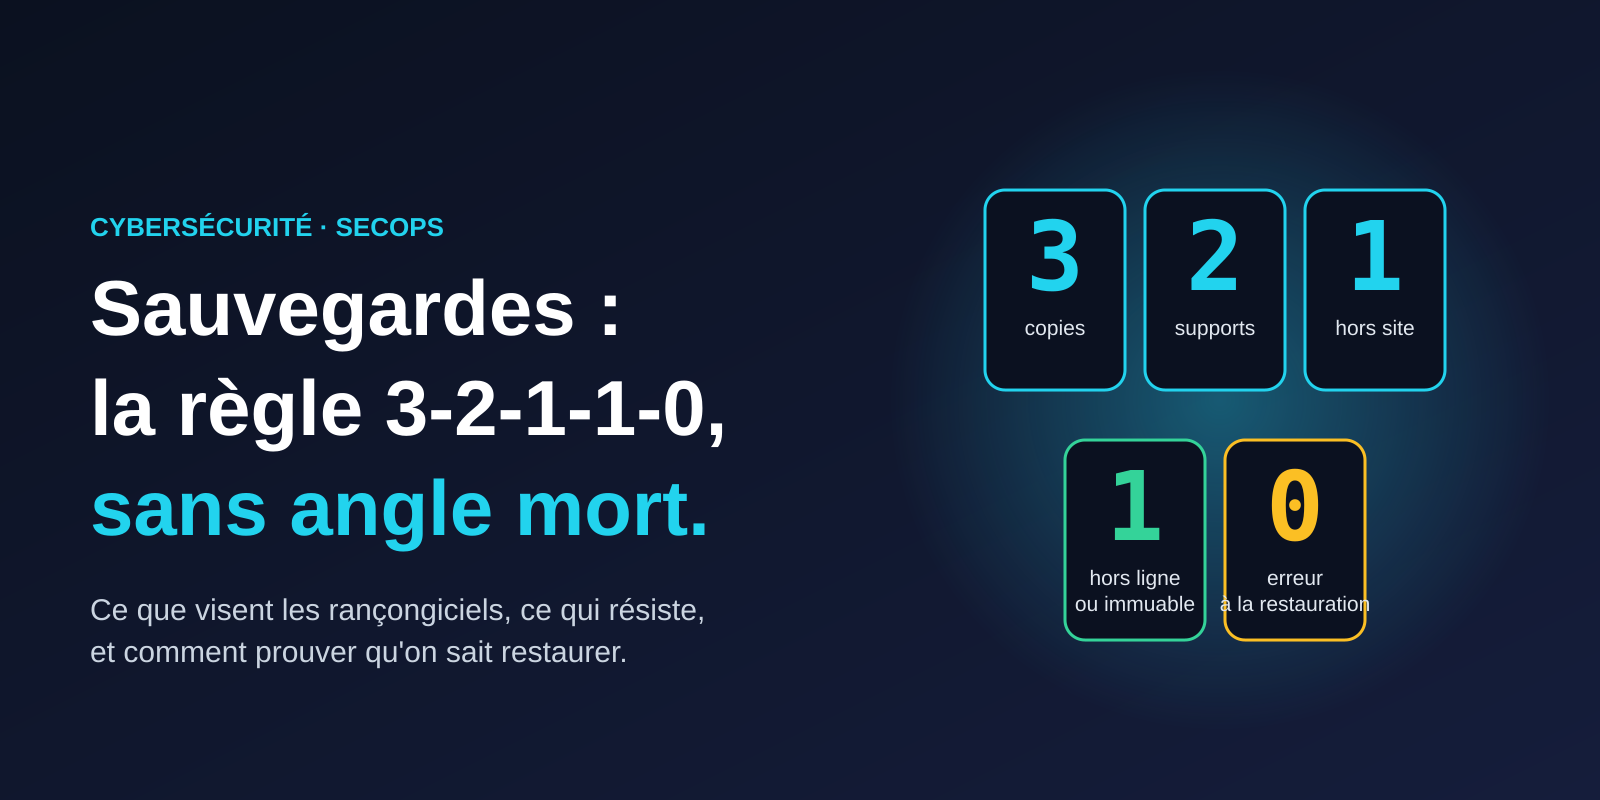
Un rançongiciel ne chiffre pas d’abord vos données : il cherche vos sauvegardes. Dans les enquêtes, presque toutes les victimes racontent la même chose, et la différence entre une reprise en quelques jours et une catastrophe tient à une seule question : existe-t-il une copie que l’attaquant, avec les identifiants qu’il a volés, ne peut ni effacer ni chiffrer ? Voici la règle 3-2-1-1-0, ce qu’elle protège vraiment, des commandes testées, et comment chiffrer le temps qu’il vous faudra pour restaurer.
Ce qu’il faut retenir
- 94 % des organisations touchées par un rançongiciel disent que les attaquants ont tenté de compromettre leurs sauvegardes, et 57 % des tentatives réussissent (Sophos, enquête 2024).
- Quand les sauvegardes sont compromises, la reprise coûte en médiane 3 M$ contre 375 000 $, soit huit fois plus, et la rançon est payée deux fois plus souvent (67 % contre 36 %).
- 3-2-1 ne suffit plus : la règle moderne ajoute une copie hors ligne ou immuable (le second « 1 ») et des restaurations testées (le « 0 »).
- Immuable ne veut pas dire protégé si la copie dépend des mêmes identifiants que la production : ce qui compte, c’est la séparation des identités.
- Le temps de restauration se calcule : 10 To à 1 Gbit/s, c’est environ 25 heures, sans compter la reconstruction de l’annuaire et des serveurs.
Les sauvegardes sont la cible numéro un
L’enquête « State of Ransomware 2024 » de Sophos (2 974 professionnels dont l’organisation avait été touchée dans l’année) donne l’ordre de grandeur : 94 % des victimes déclarent que les attaquants ont tenté de compromettre leurs sauvegardes, et 57 % de ces tentatives ont abouti. Le taux de réussite varie beaucoup selon le secteur, de 30 % dans les technologies et télécoms à 79 % dans l’énergie et les services publics.
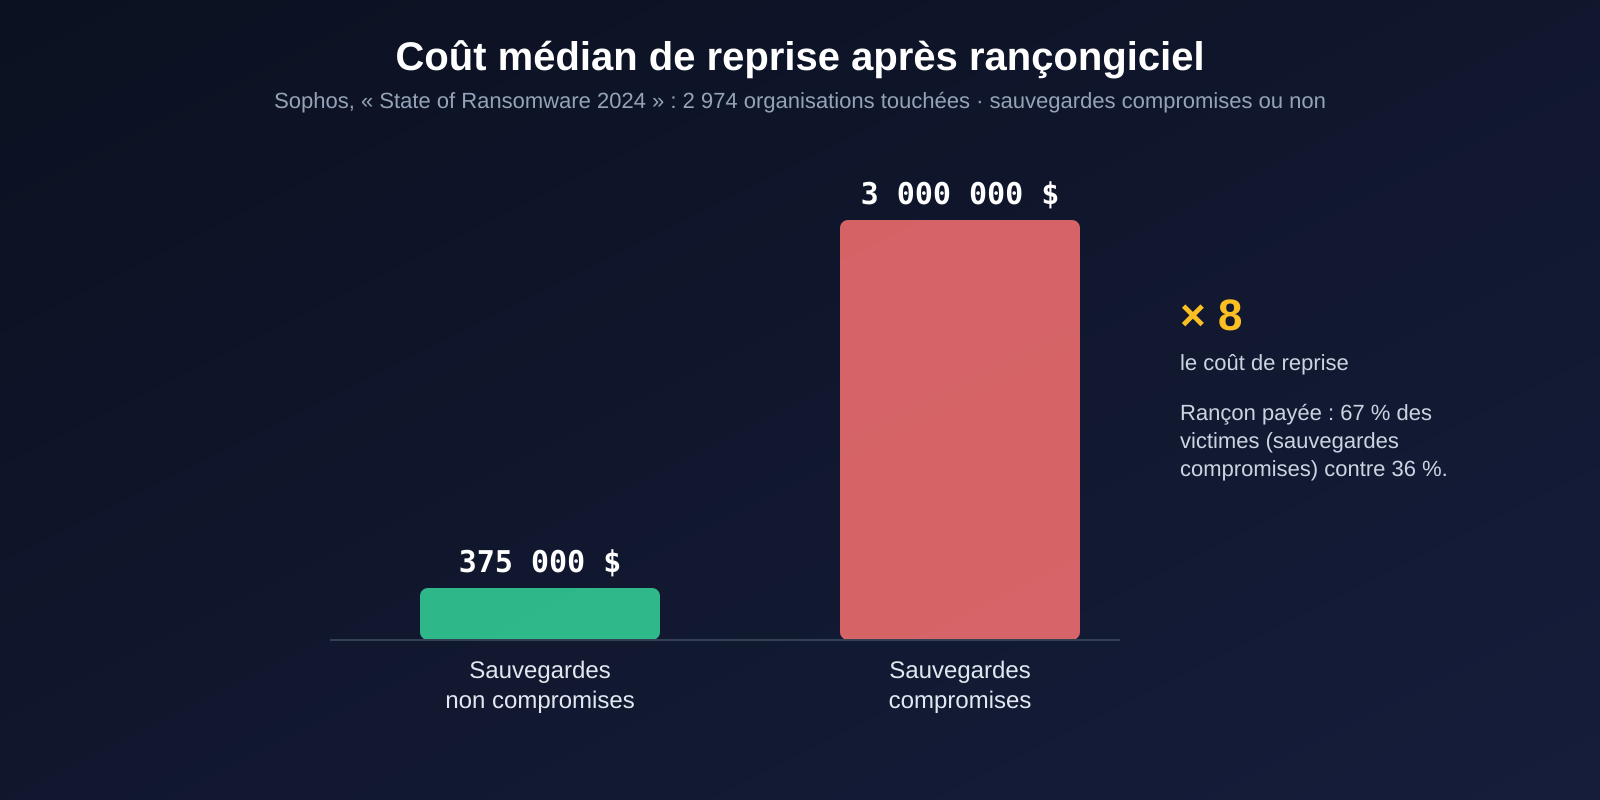
Les conséquences sont mesurables. Quand les sauvegardes sont compromises, la rançon demandée est en médiane de 2,3 M$ contre 1 M$, et les victimes acceptent de payer presque deux fois plus souvent (67 % contre 36 %). Ce n’est pas surprenant : sans copie saine, payer devient la seule option de reprise.
Et disposer de sauvegardes ne garantit pas de s’en servir. L’enquête Veeam 2025 (1 300 organisations interrogées, dont 900 victimes d’au moins une attaque avec chiffrement ou exfiltration) relève que seules 10 % des victimes ont récupéré plus de 90 % de leurs données, tandis que 57 % en ont récupéré moins de la moitié. Toutes n’ont pas perdu leurs sauvegardes : beaucoup n’ont simplement pas pu restaurer assez, assez vite, ou assez proprement.
Comment l’attaquant s’y prend
La technique porte un nom dans MITRE ATT&CK : T1490, « Inhibit System Recovery ». Elle est employée par WannaCry, LockBit 2.0, BlackCat, Conti et bien d’autres. Sous Windows, elle se résume à quelques commandes que les EDR savent d’ailleurs détecter :
vssadmin.exe delete shadows /all /quiet
wmic shadowcopy delete
wbadmin.exe delete catalog -quiet
bcdedit.exe /set {default} bootstatuspolicy ignoreallfailures
Cela ne supprime que les copies « faciles » (clichés instantanés, catalogue de sauvegarde Windows). Les attaquants expérimentés vont plus loin. Voici les chemins que l’on rencontre le plus souvent, et ce qui les bloque :
| Ce que fait l’attaquant | Pourquoi ça marche | Ce qui résiste |
|---|---|---|
| Supprime les clichés et copies locales de la machine | Ils sont sur le même disque et accessibles à tout administrateur local | Copies stockées ailleurs, pas de dépendance à l’hôte compromis |
| Se connecte à la console de sauvegarde avec un compte d’administration de domaine volé | Le serveur de sauvegarde est joint à l’annuaire, les comptes sont les mêmes | Serveur de sauvegarde hors domaine, comptes dédiés, MFA |
| Exploite une faille du logiciel de sauvegarde lui-même | Console exposée ou correctifs en retard | Console non exposée, correctifs prioritaires (voir plus bas) |
| Chiffre ou efface les dépôts montés en réseau (SMB, NFS) | Le dépôt est accessible en écriture depuis les serveurs de production | Aucun dépôt monté en écriture ; la sauvegarde se connecte à la production, pas l’inverse |
| Supprime les copies dans le cloud avec des clés d’API volées | Les clés ont un droit de suppression, sans délai | Verrouillage de rétention (Object Lock), compte cloud séparé, MFA sur la suppression |
| Attend : laisse les sauvegardes se remplir de son propre accès | Les sauvegardes récentes contiennent déjà la compromission | Rétention longue avec points anciens, analyse avant restauration |
Le logiciel de sauvegarde est lui-même une cible de choix. Dans notre analyse du catalogue KEV, Veeam Backup & Replication apparaît avec quatre entrées marquées comme utilisées par des rançongiciels. Un serveur de sauvegarde se traite donc comme un équipement de périmètre : inaccessible depuis Internet, patché en priorité, et surveillé.
De 3-2-1 à 3-2-1-1-0
La règle 3-2-1 (trois copies, deux supports, une copie hors site) protégeait bien contre les pannes et les sinistres. Elle ne dit rien d’un adversaire qui a les droits d’administrateur. La version étendue ajoute deux exigences précisément pensées pour lui :
| Chiffre | Exigence | Ce qu’elle protège |
|---|---|---|
| 3 | Trois copies des données : l’original et deux sauvegardes | Panne, erreur, suppression accidentelle |
| 2 | Deux types de supports ou de technologies différents | Défaut d’une technologie, faille commune à un même système |
| 1 | Une copie hors site | Sinistre local, vol, compromission du site entier |
| 1 | Une copie hors ligne, ou immuable, ou hors domaine d’authentification | Le rançongiciel et l’administrateur malveillant |
| 0 | Zéro erreur, prouvé par des tests de restauration | Sauvegarde corrompue, incomplète ou impossible à relire |
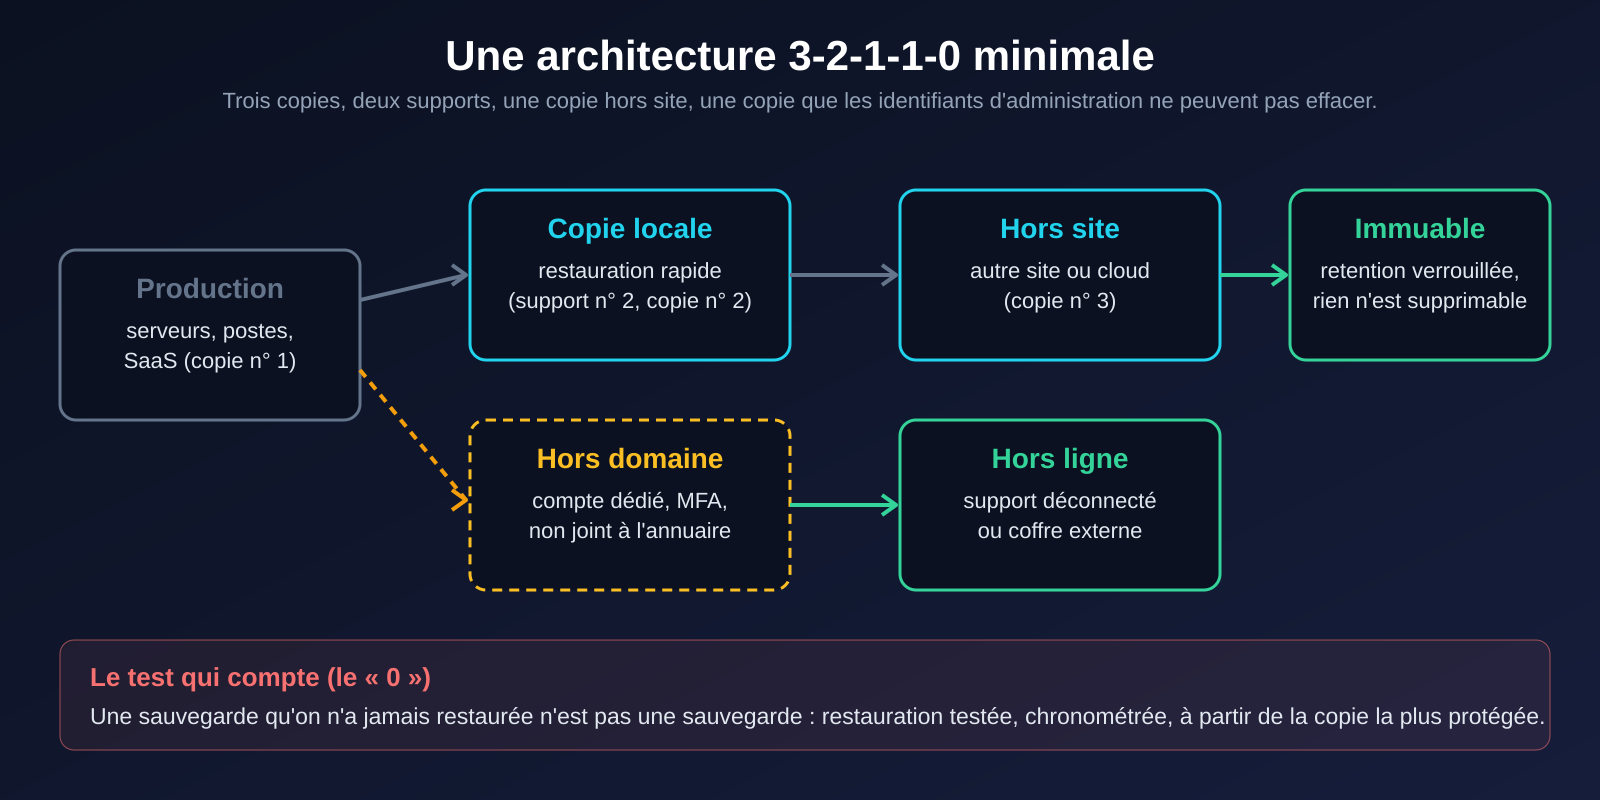
Hors ligne, immuable, hors domaine : ne pas les confondre
Ces trois notions se recouvrent mais ne protègent pas de la même chose :
- Hors ligne (air gap) : le support n’est relié à aucun réseau au moment de l’attaque (bande, disque déconnecté, coffre). Aucun accès distant ne peut l’atteindre. Contrepartie : rétention et rotation souvent manuelles, restauration plus lente.
- Immuable : le stockage refuse toute modification ou suppression avant l’échéance d’une rétention, même pour un administrateur. C’est automatisable, mais la protection ne vaut que par sa configuration et par l’impossibilité, pour l’attaquant, de la contourner.
- Hors domaine : la copie est gérée par des identifiants et un annuaire qui n’existent pas dans la production. C’est la mesure qui casse la plupart des scénarios où l’attaquant a volé un compte d’administrateur du domaine.
Trois pièges reviennent régulièrement :
- L’immuabilité pilotée par le même compte. Si le compte qui configure la rétention est celui que l’attaquant a volé, il peut arrêter les futures sauvegardes, ou les écrire avec une rétention d’un jour. L’immuabilité protège le passé, pas l’avenir : il faut donc aussi superviser que les sauvegardes s’exécutent et que leur rétention n’a pas été modifiée.
- Le mode « gouvernance » n’est pas l’immuabilité forte. Sur le stockage objet S3, le mode Governance laisse des utilisateurs disposant d’une permission spéciale lever la protection ; seul le mode Compliance interdit à tout le monde, y compris au compte racine, de supprimer ou raccourcir avant l’échéance. Ce dernier est irréversible : à choisir en connaissance de cause.
- Pousser plutôt que tirer. Si les serveurs de production détiennent des identifiants pour écrire sur le serveur de sauvegarde, l’attaquant qui prend un serveur les récupère. Le principe le plus efficace est inverse : c’est le serveur de sauvegarde qui se connecte à la production (« pull ») ; la production ne possède aucun identifiant qui permette d’écrire ou de supprimer chez lui.
Mise en pratique
Un dépôt « en ajout seul » sous Linux : restic et rest-server
Ce montage a été testé pour cet article avec restic 0.19.1 et rest-server 0.14.0 (binaires officiels, machine de test isolée). Le serveur de sauvegarde est lancé en mode « ajout seul » : un client peut écrire de nouvelles données, jamais supprimer ni écraser.
# Sur le serveur de sauvegarde
rest-server --path /srv/restic --listen :8000 --append-only --htpasswd-file /srv/restic/.htpasswd

# Sur la machine à sauvegarder
export RESTIC_REPOSITORY=rest:https://sauvegarde.exemple.lan:8000/serveur1
export RESTIC_PASSWORD_FILE=/root/.restic-pass
restic init
restic backup /srv/data
Puis on joue le rôle de l’attaquant, qui a volé les identifiants du client et tente de détruire l’historique. Résultats observés :
$ restic forget --keep-last 1
remove 1 snapshots:
Remove(<snapshot/e0b774aba7>) failed: unexpected HTTP response (403): 403 Forbidden
failed to remove one or more snapshots

$ curl -X DELETE http://serveur:8000/keys/<id>        -> 403 Forbidden
$ curl -X DELETE http://serveur:8000/data/<id>        -> 403 Forbidden
$ curl -X POST --data x http://serveur:8000/snapshots/<id>   -> 403 Forbidden

$ restic check          -> no errors were found
$ restic restore latest --target /restore # données identiques à l'original- La purge passe côté serveur. Comme le client ne peut pas supprimer, la rotation (
forget --prune) se lance localement sur le serveur de sauvegarde, avec un compte que la production ne connaît pas. - Un prune refusé peut laisser un verrou. Lors de nos essais, un
forget --pruneéchoué depuis le client a laissé un verrou exclusif dans le dépôt, qui a bloqué les commandes suivantes jusqu’à un nettoyage côté serveur. Ne lancez pas de purge depuis le client. - Le mode ajout seul protège contre la suppression, pas contre le chiffrement du serveur lui-même. Si l’attaquant obtient un accès root au serveur de sauvegarde, il fait ce qu’il veut : ce serveur ne doit pas être joint à l’annuaire de production.
Le stockage objet avec verrouillage de rétention (S3 Object Lock)
Pour la copie hors site, le verrouillage d’objets est la brique standard. Les commandes ci-dessous sont celles de la documentation AWS ; elles n’ont pas été exécutées pour cet article, faute de compte cloud. Le compartiment doit être créé avec le verrouillage activé (cela active aussi le versionnement) :
aws s3api create-bucket --bucket sauvegardes-immuables --region eu-west-3 \
  --create-bucket-configuration LocationConstraint=eu-west-3 \
  --object-lock-enabled-for-bucket

aws s3api put-object-lock-configuration --bucket sauvegardes-immuables \
  --object-lock-configuration '{"ObjectLockEnabled":"Enabled","Rule":{"DefaultRetention":{"Mode":"COMPLIANCE","Days":30}}}'
À faire avec un compte cloud séparé de celui de la production, une clé d’accès qui n’a que le droit d’écrire (pas s3:BypassGovernanceRetention, pas de suppression de versions), et une authentification multifacteur sur les opérations sensibles.
ZFS : figer un instantané
Sur un serveur de sauvegarde ZFS, un instantané peut être protégé contre la suppression par un « hold » :
zfs snapshot tank/backups@2026-09-29
zfs hold sauvegarde tank/backups@2026-09-29
zfs destroy tank/backups@2026-09-29      # refusé : le snapshot a un hold
zfs release sauvegarde tank/backups@2026-09-29   # à ne faire qu'après l'échéance
Attention : c’est une protection contre l’erreur et le script hâtif, pas contre un attaquant root sur le serveur ZFS lui-même, qui peut lever le hold. Combinez-la avec le principe « pull » et un serveur de sauvegarde inaccessible depuis la production.
Le « 0 » : prouver qu’on sait restaurer
Un test de restauration comporte trois niveaux, à pratiquer à des fréquences différentes :
| Niveau | Ce qu’on vérifie | Fréquence |
|---|---|---|
| 1. Intégrité | Les données du dépôt sont lisibles et non corrompues (vérification par somme de contrôle) | Automatique, chaque semaine |
| 2. Restauration d’échantillon | Des fichiers pris au hasard sont restaurés et comparés à l’original | Automatique, chaque semaine ou chaque mois |
| 3. Restauration complète | Un service entier est reconstruit dans un réseau isolé, démarre, et est testé par ses utilisateurs ; on chronomètre | Au moins une fois par an, et après tout changement majeur |
Voici un script de test hebdomadaire, testé avec restic 0.19.1, y compris dans le cas d’échec. Il suppose qu’un fichier SHA256SUMS est généré dans le répertoire sauvegardé avant chaque sauvegarde (cd /srv/data && sha256sum fichiers-témoins* > SHA256SUMS) :
#!/bin/bash
# Test de restauration hebdomadaire : intégrité, puis restauration vérifiée par somme de contrôle.
set -euo pipefail
export RESTIC_REPOSITORY=rest:https://sauvegarde.exemple.lan:8000/serveur1
export RESTIC_PASSWORD_FILE=/root/.restic-pass
DEST=$(mktemp -d /var/tmp/restore-test.XXXXXX)
trap 'rm -rf "$DEST"' EXIT

restic check --read-data-subset=10%       # niveau 1 : structure + 10 % des données relues
restic restore latest --target "$DEST"    # niveau 2 : restauration du dernier instantané
cd "$(dirname "$(find "$DEST" -name SHA256SUMS | head -1)")"
sha256sum --quiet -c SHA256SUMS           # comparaison avec la liste établie avant la sauvegarde
echo "restauration OK : $(wc -l < SHA256SUMS) fichiers vérifiés, $(date -Is)"
Cas de réussite : restauration OK : 4 fichiers vérifiés, code de sortie 0. Cas d’échec simulé (un fichier différent de la liste) : f1.txt: FAILED, sha256sum: WARNING: 1 computed checksum did NOT match, code de sortie 1. Branchez ce code de sortie sur votre supervision : un test qui échoue en silence ne vaut rien.
Le niveau 3 est celui qu’on saute le plus souvent, et c’est le seul qui donne un temps de reprise fiable.
Chiffrer le temps de restauration
Le temps de restauration est un calcul, pas une impression. Voici la durée théorique pour des débits soutenus de 110 Mo/s (un lien à 1 Gbit/s bien utilisé) et de 1 100 Mo/s (10 Gbit/s) :
| Volume à restaurer | 1 Gbit/s (110 Mo/s) | 10 Gbit/s (1 100 Mo/s) |
|---|---|---|
| 1 To | environ 2 h 30 | environ 15 min |
| 10 To | environ 25 h | environ 2 h 30 |
| 50 To | environ 5,3 jours | environ 12 h 30 |
Ce sont des minimums : la déduplication, la reconstitution des données et les millions de petits fichiers abaissent souvent le débit réel. Ajoutez le temps de reconstruire ce qui doit exister avant les données : le réseau, l’annuaire, le DNS, la gestion de certificats, et le serveur de sauvegarde lui-même.
L’ordre de restauration se prépare donc à l’avance : d’abord le socle d’identité et de réseau, ensuite les outils de sécurité et de sauvegarde (reconstruits proprement), puis les applications critiques, enfin le reste. Et on restaure dans un réseau isolé, avec analyse des données restaurées : c’est le même principe que celui de notre article sur le sanity check après incident.
Les pièges à éviter
- Un serveur de sauvegarde joint à l’annuaire de production : un seul compte d’administrateur volé donne accès à tout.
- Perdre la clé de chiffrement. Une sauvegarde chiffrée dont la phrase secrète est stockée sur le serveur sauvegardé est irrécupérable après un incident. Conservez-la hors ligne, séparément, et testez son usage.
- Un dépôt monté en lecteur réseau sur les serveurs : il sera chiffré avec le reste.
- Des clichés et snapshots gérés depuis la même console que la production (hyperviseur, baie de stockage) : l’attaquant qui prend la console les supprime.
- Une rétention trop courte. Si l’attaquant est là depuis trois semaines et que vous gardez quinze jours de sauvegardes, toutes sont contaminées. Gardez quelques points plus anciens (hebdomadaires, mensuels).
- Sauvegarder sans jamais vérifier que les tâches s’exécutent : une alerte « aucune sauvegarde depuis 48 heures » vaut mieux que la découverte du problème le jour du sinistre.
- Ne pas sauvegarder les services SaaS (messagerie, documents, code) en supposant que le fournisseur le fait : vérifiez la rétention réelle et la procédure de restauration de votre abonnement.
Huit questions pour auto-évaluer votre situation
- Existe-t-il une copie que aucun compte de la production ne peut supprimer ?
- Le serveur de sauvegarde est-il hors du domaine d’authentification de production ?
- La console de sauvegarde est-elle inaccessible depuis Internet et depuis le réseau des utilisateurs ?
- La production n’a-t-elle aucun identifiant lui permettant d’écrire sur la sauvegarde ?
- Une alerte se déclenche-t-elle si une sauvegarde échoue ou si la rétention est modifiée ?
- La phrase secrète de chiffrement est-elle conservée hors ligne ?
- Avez-vous restauré un service complet dans les douze derniers mois, chronomètre en main ?
- Votre temps de restauration calculé est-il compatible avec ce que l’entreprise peut supporter d’arrêt ?
Un « non » à l’une de ces questions est une priorité. Un « je ne sais pas » en est une aussi.
En résumé
Les sauvegardes sont la première cible d’un rançongiciel parce qu’elles décident de l’issue : avec une copie saine, on restaure ; sans, on négocie. La règle 3-2-1-1-0 exprime cette réalité en une ligne, à condition de la lire avec ses trois exigences cachées : une copie que les identifiants de production ne peuvent pas atteindre, une architecture où la sauvegarde va chercher les données plutôt que d’être poussée, et des restaurations réellement pratiquées. Le reste est de l’ingénierie.
Transparence : cet article a été rédigé avec l’aide d’un assistant Claude. Les chiffres d’enquêtes sont ceux publiés par Sophos (2024) et Veeam (2025). Les commandes marquées comme testées ont été exécutées pour cet article ; les commandes S3 et ZFS proviennent de la documentation officielle et doivent être vérifiées dans votre environnement. Références consultées en septembre 2026.
À lire aussi
- KEV : ce que 1 728 vulnérabilités exploitées disent de vos priorités : les logiciels de sauvegarde figurent au catalogue des failles exploitées.
- Rançongiciels : ce qui se passe avant le chiffrement : la chronologie qui mène à l’effacement des sauvegardes puis au chiffrement.
Sources
- Sophos, « The impact of compromised backups on ransomware outcomes » (State of Ransomware 2024) : sophos.com
- Veeam, « 2025 Ransomware Trends and Proactive Strategies Report » (communiqué du 23 avril 2025) : veeam.com
- MITRE ATT&CK, T1490 « Inhibit System Recovery » : attack.mitre.org
- restic, documentation : restic.readthedocs.io ; rest-server : github.com/restic/rest-server
- AWS, S3 Object Lock : docs.aws.amazon.com
- OpenZFS, zfs-hold : openzfs.github.io
- KillChain, analyse du catalogue KEV (Veeam Backup & Replication) : killchain.fr