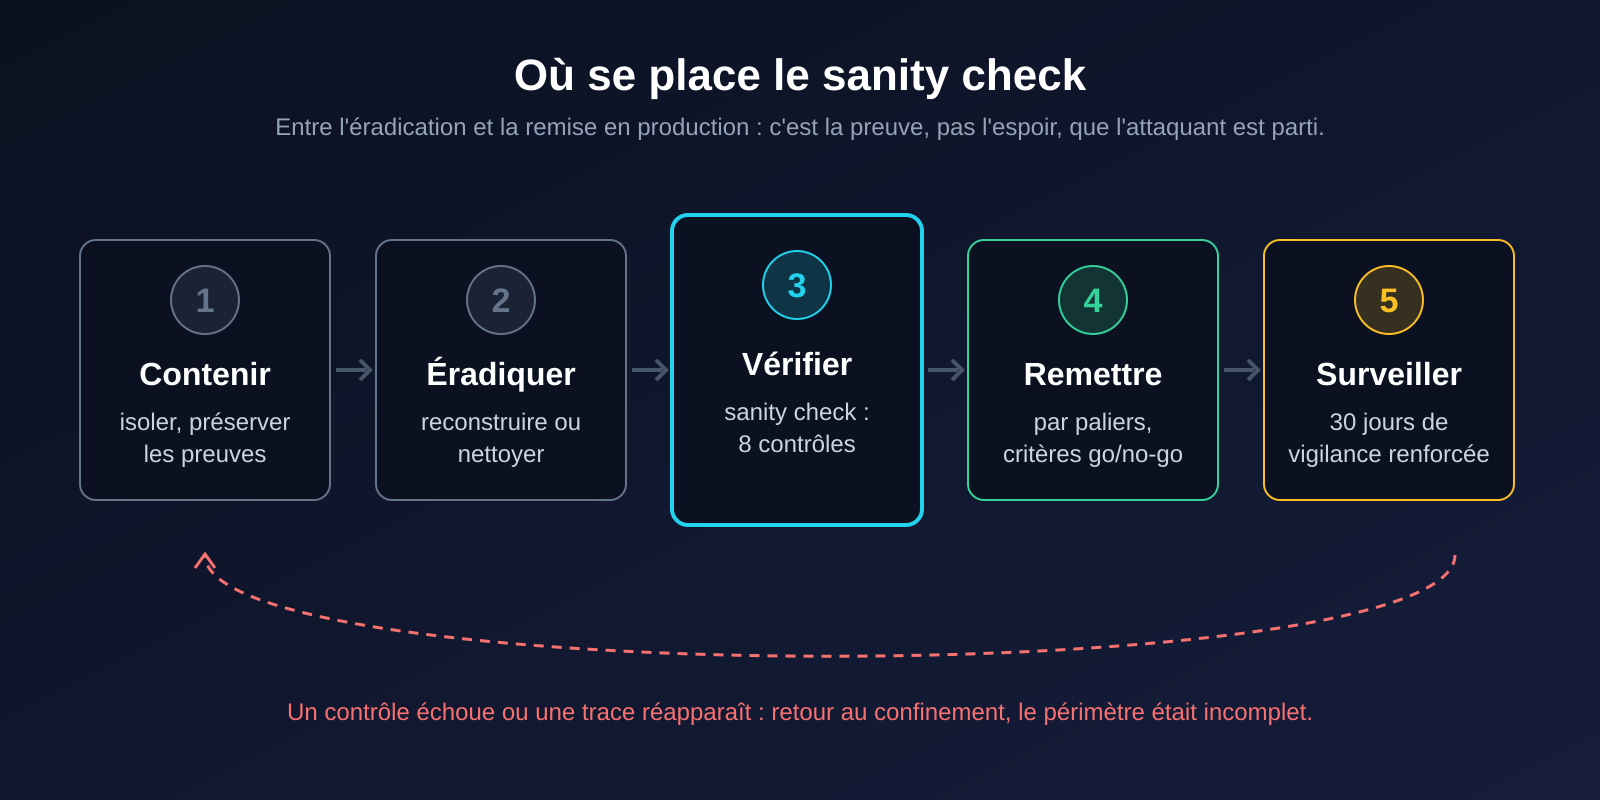
Le malware est supprimé, les postes sont réinstallés, la direction demande quand on rouvre. C’est le moment le plus dangereux d’un incident : celui où l’on remet en service un système en espérant que l’attaquant est parti. Le sanity check sert à remplacer cet espoir par des preuves. Voici une méthode, des critères de sortie et les commandes concrètes pour Linux, Windows, Active Directory et le cloud.
Pourquoi « on a supprimé le malware » ne suffit pas
Un attaquant qui a eu plusieurs jours d’accès ne laisse presque jamais une seule porte. Il crée des comptes, ajoute des clés SSH, pose une tâche planifiée, vole des jetons cloud, parfois modifie un module d’authentification. L’antivirus retrouve le binaire le plus visible ; il ne voit pas un compte de service légitime dont le mot de passe a été volé, ni une règle de transfert de messagerie.
Les agences le répètent. L’avis conjoint AA20-245A de la CISA et de ses partenaires (Five Eyes, 2020) liste les erreurs classiques de gestion d’incident : effacer les machines avant d’avoir collecté les preuves, bloquer trop tôt les adresses de l’attaquant (qui change alors d’infrastructure et devient invisible), réinitialiser les mots de passe au fil de l’eau au lieu d’une remédiation coordonnée. L’ANSSI, dans son guide « Piloter la remédiation d’un incident cyber », insiste sur le même point : la remédiation se prépare et s’exécute comme une opération, pas comme une suite de nettoyages.
Avant de commencer : trois prérequis
- Une date de première compromission (T0) défendable. Tout en découle : quelles sauvegardes sont sûres, quels secrets ont pu être exposés, quelle fenêtre de journaux relire. Si T0 est incertaine, prendre la plus ancienne hypothèse crédible.
- La liste des techniques observées, idéalement rattachées à MITRE ATT&CK (voir comment exploiter les fiches de groupes). Elle transforme une vérification générique en vérification ciblée : si l’attaquant a utilisé des tâches planifiées sur trois serveurs, on les cherche sur tous les serveurs.
- Les preuves déjà collectées. Images disque et mémoire, journaux exportés hors du périmètre compromis. Un sanity check modifie parfois l’état des machines : il vient après la collecte, jamais avant.
Un mot sur le choix reconstruire ou nettoyer : pour tout système où l’attaquant a obtenu des droits administrateur, la reconstruction à partir d’une source saine (image maîtrisée, installation propre, configuration rejouée depuis l’outil de gestion) est la règle. Le sanity check s’applique quand même : un serveur reconstruit récupère des données, des secrets et une configuration qui, eux, peuvent être piégés.
1. Les identités : le contrôle qui compte le plus
La majorité des réinfections viennent d’un accès d’identité resté valide, pas d’un binaire oublié. C’est donc le premier contrôle, et le plus long.
Active Directory
Objectif : vérifier qu’aucun compte, groupe, délégation ou droit n’a été ajouté pendant la fenêtre de compromission, puis invalider tous les tickets Kerberos existants.
# Comptes et groupes privilégiés (module ActiveDirectory)
$T0 = Get-Date "2026-09-01"
"Domain Admins","Enterprise Admins","Schema Admins","Administrators","Account Operators","Backup Operators" |
  ForEach-Object { Get-ADGroupMember $_ -Recursive | Select-Object @{n="Groupe";e={$_}},SamAccountName }

# Objets protégés (adminCount=1) et comptes créés depuis T0
Get-ADObject -LDAPFilter "(adminCount=1)" -Properties whenChanged | Sort-Object whenChanged -Descending
Get-ADUser -Filter {whenCreated -ge $T0} -Properties whenCreated | Select-Object SamAccountName,whenCreated

# SIDHistory (élévation discrète) et délégations dangereuses
Get-ADUser -Filter * -Properties SIDHistory | Where-Object { $_.SIDHistory }
Get-ADComputer -Filter {TrustedForDelegation -eq $true} | Select-Object Name
Get-ADComputer -Filter * -Properties msDS-AllowedToActOnBehalfOfOtherIdentity |
  Where-Object { $_."msDS-AllowedToActOnBehalfOfOtherIdentity" } | Select-Object Name

# Stratégies de groupe modifiées récemment
Get-GPO -All | Where-Object { $_.ModificationTime -ge $T0 } | Select-Object DisplayName,ModificationTime
Ces requêtes ne voient pas tout : les ACL piégées (droits de réplication permettant un DCSync, ACL modifiée sur l’objet AdminSDHolder, qui se propage toutes les heures aux comptes protégés) se vérifient mieux avec un outil d’audit dédié : ORADAD de l’ANSSI ou PingCastle. Comparer le résultat à un audit antérieur à l’incident est le moyen le plus fiable de repérer ce qui a changé.
Enfin, le compte krbtgt : si un contrôleur de domaine a été compromis, l’attaquant a pu forger des « golden tickets ». Son mot de passe doit être réinitialisé deux fois, avec entre les deux un délai au moins égal à la durée de vie maximale d’un ticket (10 heures par défaut) plus le temps de réplication. Microsoft fournit un script qui contrôle la réplication entre les deux passages : New-KrbtgtKeys.ps1.
Linux
# Comptes UID 0 autres que root, comptes avec shell, membres des groupes d'administration
awk -F: '$3 == 0 && $1 != "root" {print "UID0 :", $1}' /etc/passwd
awk -F: '$7 !~ /(nologin|false)$/ {print $1, $7}' /etc/passwd
getent group sudo wheel adm

# Droits sudo et clés SSH (y compris un AuthorizedKeysFile détourné)
cat /etc/sudoers; ls -la /etc/sudoers.d/
sshd -T | grep -Ei 'authorizedkeys(file|command)|permitrootlogin'
find / -xdev ( -name 'authorized_keys*' -o -name '*.pub' ) -newermt "2026-09-01" -ls 2>/dev/null
Cloud et messagerie (Microsoft 365 / Entra ID)
C’est l’angle mort le plus fréquent : réinitialiser un mot de passe ne révoque pas les jetons déjà émis, ni les accès accordés à des applications. À vérifier pour chaque compte touché, et globalement pour le locataire :
- révoquer les sessions (
Revoke-MgUserSignInSession) après le changement de mot de passe ; - méthodes MFA ajoutées depuis T0 (un second téléphone enregistré par l’attaquant survit à tout le reste) ;
- consentements OAuth accordés à des applications inconnues (
Get-MgOauth2PermissionGrant) et secrets ou certificats ajoutés aux principaux de service ; - règles de boîte de réception et transferts (
Get-InboxRule,ForwardingSmtpAddress) : la persistance favorite des fraudes au virement ; - configuration de fédération des domaines : un certificat de signature ajouté permet de forger des jetons SAML (technique documentée lors de la campagne SolarWinds).
2. La persistance : chercher partout ce qu’on a trouvé quelque part
Le tableau ci-dessous liste les mécanismes les plus courants, avec leur identifiant ATT&CK et l’endroit où regarder. Règle d’or : toute persistance trouvée sur une machine devient un critère de recherche sur tout le parc.
| Mécanisme | ATT&CK | Où regarder |
|---|---|---|
| Cron | T1053.003 | /etc/crontab, /etc/cron.*, /var/spool/cron/ |
| Service ou timer systemd | T1543.002 / T1053.006 | systemctl list-timers --all, unités dans /etc/systemd/system modifiées depuis T0 |
| Préchargement de bibliothèque | T1574.006 | /etc/ld.so.preload (normalement absent), variable LD_PRELOAD |
| Module PAM piégé | T1556.003 | /etc/pam.d/, modules pam_*.so n’appartenant à aucun paquet |
| Clé SSH ajoutée | T1098.004 | authorized_keys de tous les comptes, y compris de service |
| Web shell | T1505.003 | fichiers .php, .jsp, .aspx récents dans les racines web |
| Clés Run / Démarrage | T1547.001 | HKLM…Run, HKCU…Run, dossiers Démarrage |
| Tâche planifiée Windows | T1053.005 | schtasks /query /fo csv /v, événement 4698 |
| Service Windows | T1543.003 | événements 7045 (Système) et 4697 (Sécurité) |
| Abonnement WMI | T1546.003 | espace de noms rootsubscription |
# Linux : fichiers de démarrage et d'authentification modifiés depuis T0
find /etc/systemd /usr/lib/systemd /etc/cron* /var/spool/cron /etc/pam.d /etc/profile.d
     /etc/ld.so.preload /etc/rc.local -newermt "2026-09-01" -type f -ls 2>/dev/null

# Modules PAM absents de tout paquet (Debian/Ubuntu)
for f in /lib/*/security/*.so /usr/lib/*/security/*.so; do
  [ -e "$f" ] && ! dpkg -S "*/security/$(basename "$f")" >/dev/null 2>&1 && echo "Hors paquet : $f"
done
# Windows : inventaire complet des points d'auto-démarrage (Sysinternals Autoruns, ligne de commande)
autorunsc64.exe -accepteula -a * -c -h -s -m > autoruns.csv
# -a * : toutes les catégories -h : empreintes -s : vérifie les signatures -m : masque les entrées Microsoft
# Abonnements WMI permanents (quasi inexistants sur un poste standard)
Get-CimInstance -Namespace root/subscription -ClassName __EventFilter
Get-CimInstance -Namespace root/subscription -ClassName CommandLineEventConsumer
Get-CimInstance -Namespace root/subscription -ClassName __FilterToConsumerBindingL’export Autoruns prend toute sa valeur en comparaison : le même export réalisé sur une machine saine de même rôle fait ressortir immédiatement les entrées en trop.
3. L’intégrité : les binaires sont-ils ceux du paquet ?
Les gestionnaires de paquets conservent les empreintes des fichiers installés. Un binaire système modifié (sshd, sudo, ls) est un signal très fort.
dpkg --verify                 # Debian/Ubuntu : liste les fichiers dont l'empreinte diffère (un « 5 » en 3e caractère)
debsums -c                    # alternative, fichiers modifiés uniquement
rpm -Va                       # RHEL/Rocky/Alma : "5" = empreinte différente
find / -xdev -perm -4000 -type f -newermt "2026-09-01" -ls 2>/dev/null   # nouveaux binaires setuid
ls -la /tmp /var/tmp /dev/shm # exécutables en zone temporaire
cat /proc/sys/kernel/tainted  # différent de 0 : module noyau hors arbre ou non signé chargé
Limite importante : ces outils tournent sur la machine vérifiée. Si l’attaquant a obtenu un accès noyau (rootkit), le système peut mentir à ses propres commandes. En cas de doute sérieux, on analyse le disque hors ligne, depuis un système sain, ou l’on reconstruit sans discuter.
4. Le réseau : qui parle à qui ?
Une machine saine a un comportement réseau prévisible. On compare l’état actuel à une référence (même rôle, ou même machine avant l’incident).
ss -tunap                          # sockets ouverts avec le processus associé
ss -tnp state established          # connexions actives, à comparer à la liste des flux légitimes
Get-NetTCPConnection -State Established,Listen |
  Select-Object LocalPort,RemoteAddress,RemotePort,@{n="Proc";e={(Get-Process -Id $_.OwningProcess).Name}}
Mais la vraie preuve est extérieure à la machine : journaux du pare-feu et du résolveur DNS sur toute la fenêtre de compromission, recherche des domaines et adresses de l’attaquant, et détection de balises (connexions régulières vers la même destination, à intervalle fixe). Pendant la période de surveillance, n’autoriser en sortie que les flux strictement nécessaires rend toute tentative de rappel immédiatement visible.
5. La chasse aux indicateurs à l’échelle du parc
Vérifier dix serveurs à la main est faisable ; mille postes ne l’est pas. Deux familles d’outils aident :
- Scanners d’indicateurs : LOKI (et son successeur Loki-RS) ou THOR Lite, qui combinent règles YARA, empreintes et noms de fichiers. On y ajoute les indicateurs propres à l’incident et ceux publiés par le CERT-FR ;
- Plateformes de collecte : Velociraptor (open source) permet de lancer la même requête (tâches planifiées, clés Run, exécutables récents, règle YARA) sur tout le parc et d’obtenir le résultat en quelques minutes. C’est l’outil idéal pour appliquer la règle « ce qu’on a trouvé quelque part, on le cherche partout ».
Un résultat négatif n’est une preuve que si l’on sait ce qu’on cherchait. D’où l’importance de la liste des techniques observées : un scan générique « propre » ne dit presque rien.
6. Les journaux : l’attaquant a-t-il éteint les caméras ?
Avant de remettre en production, s’assurer que la détection fonctionne vraiment : un attaquant soigneux désactive la journalisation ou l’agent EDR, et le silence qui suit ressemble à un système sain.
- agents EDR/SIEM présents, à jour et qui remontent (vérifier l’horodatage du dernier événement reçu, pas seulement le service) ;
- Windows : journal effacé (événements 1102 Sécurité, 104 Système), audit de création de processus (4688) actif, journal PowerShell (4104) actif ;
- événements à surveiller en priorité après la remise : 4720 (compte créé), 4728/4732/4756 (ajout à un groupe), 4698 (tâche planifiée), 7045 (service), 4672 (privilèges spéciaux) ;
- Linux :
auditdetjournaldactifs, pas de trou dans les journaux, pas de fichier de journal tronqué (wtmp,lastlog) ; - horloges synchronisées : sans NTP fiable, impossible de corréler les événements entre machines.
7. Les sauvegardes : restaurer, oui, mais laquelle ?
- choisir un point de restauration antérieur à T0, pas simplement antérieur au chiffrement ou à la découverte ;
- analyser la sauvegarde avant de la restaurer (mêmes indicateurs, mêmes règles YARA) : une persistance posée avant T0 connu serait restaurée avec le reste ;
- vérifier que l’attaquant n’a pas eu accès à la console de sauvegarde (suppression de points, modification de la rétention, chiffrement des dépôts) ;
- tester la restauration réellement : une sauvegarde jamais restaurée est une hypothèse.
8. Les secrets : tout ce qui a transité doit changer
Les mots de passe utilisateurs sont la partie visible. Il faut aussi renouveler tout ce qui était lisible depuis les systèmes compromis : comptes de service, clés d’API, clés privées SSH et TLS, secrets d’applications (.env, fichiers de configuration), clés d’accès cloud, identifiants de bases de données, clés partagées de VPN. Une astuce : chercher dans les dépôts de code et les partages réseau les secrets en clair, l’attaquant l’a probablement déjà fait.
Les critères de sortie : un go/no-go écrit
La remise en production se décide sur des critères, pas sur une impression. Exemple de grille, à valider par le responsable de la gestion de crise :
| Critère | Preuve attendue | Bloquant ? |
|---|---|---|
| Identités privilégiées revues | export des groupes comparé à la référence, écarts expliqués | Oui |
| krbtgt renouvelé deux fois | horodatage des deux réinitialisations, réplication vérifiée | Oui si DC touché |
| Sessions et jetons cloud révoqués | journal d’audit de la révocation | Oui |
| Aucune persistance connue sur le parc | résultat de la chasse Velociraptor / LOKI | Oui |
| Intégrité des binaires | dpkg --verify / rpm -Va sans écart inexpliqué | Oui |
| Journalisation et EDR opérationnels | dernier événement reçu par le SIEM pour chaque machine | Oui |
| Secrets renouvelés | inventaire des secrets avec date de rotation | Oui |
| Filtrage sortant restreint | règles du pare-feu pendant la période de surveillance | Recommandé |
Après la remise : 30 jours de vigilance renforcée
L’attaquant connaît l’environnement, il peut revenir par une porte oubliée ou par un nouvel accès acheté. Pendant le mois qui suit :
- alertes à seuil bas sur les événements d’identité (création de compte, ajout à un groupe privilégié, nouvelle méthode MFA, nouveau consentement OAuth) ;
- leurres : un compte administrateur jamais utilisé, un fichier « mots_de_passe.xlsx » sur un partage, une clé d’API factice (« canary tokens ») : toute utilisation est une alerte certaine ;
- revue quotidienne des connexions sortantes vers des destinations nouvelles ;
- retour d’expérience écrit : ce qui a permis l’entrée initiale doit être corrigé avant la clôture, sinon on prépare le prochain incident.
Un script de départ (lecture seule)
Pour Linux, voici une base à adapter, qui ne modifie rien et produit un rapport à comparer entre machines de même rôle :
#!/usr/bin/env bash
# sanity-check.sh : collecte en lecture seule, à lancer en root. Usage : ./sanity-check.sh 2026-09-01
T0="${1:?date de première compromission AAAA-MM-JJ}"
OUT="sanity-$(hostname)-$(date +%F).txt"
{
  echo "== Comptes UID 0";            awk -F: '$3==0' /etc/passwd
  echo "== Comptes avec shell";       awk -F: '$7 !~ /(nologin|false)$/{print $1,$7}' /etc/passwd
  echo "== sudoers.d";                ls -la /etc/sudoers.d/
  echo "== Clés SSH";                 find / -xdev -name 'authorized_keys*' -exec ls -l {} ; -exec cat {} ; 2>/dev/null
  echo "== ld.so.preload";            cat /etc/ld.so.preload 2>/dev/null || echo "absent (normal)"
  echo "== Timers systemd";           systemctl list-timers --all --no-pager
  echo "== Services activés";         systemctl list-unit-files --state=enabled --no-pager
  echo "== Crons";                    cat /etc/crontab; ls -la /etc/cron.* /var/spool/cron/crontabs 2>/dev/null
  echo "== Fichiers modifiés depuis $T0 (config)"
  find /etc /usr/lib/systemd -xdev -type f -newermt "$T0" -ls 2>/dev/null
  echo "== Setuid récents";           find / -xdev -perm -4000 -type f -newermt "$T0" -ls 2>/dev/null
  echo "== Intégrité paquets";        command -v dpkg >/dev/null && dpkg --verify || rpm -Va
  echo "== Noyau teinté";             cat /proc/sys/kernel/tainted
  echo "== Sockets";                  ss -tunap
} > "$OUT" 2>&1
echo "Rapport : $OUT"
En résumé
Un sanity check réussi n’est pas l’absence d’alerte, c’est la présence de preuves : chaque identité privilégiée expliquée, chaque persistance connue cherchée partout, chaque secret exposé renouvelé, et une détection qui fonctionne. Si un seul critère bloquant manque, la bonne réponse à « quand est-ce qu’on rouvre ? » est « pas encore », et c’est la réponse la moins coûteuse.
Transparence : cet article a été rédigé avec l’aide d’un assistant Claude. Les commandes sont données à titre d’exemple et doivent être testées dans votre environnement ; les références ci-dessous ont été vérifiées en septembre 2026.
À lire aussi
- Le bastion : la porte unique de l’administration : centraliser et tracer l’administration, recommandations ANSSI, solutions et pièges.
- Groupes APT : de la fiche MITRE ATT&CK aux priorités de détection : transformer les fiches de groupes d’attaquants en règles de détection concrètes.
Sources
- NIST SP 800-61 Rev. 3, « Incident Response Recommendations and Considerations for Cybersecurity Risk Management » (avril 2025) : csrc.nist.gov
- CISA et partenaires, avis AA20-245A « Technical Approaches to Uncovering and Remediating Malicious Activity » (2020) : cisa.gov
- ANSSI, « Piloter la remédiation d’un incident cyber » (série Cyberattaques et remédiation) : messervices.cyber.gouv.fr
- ANSSI, ORADAD (collecte et audit Active Directory) : github.com/ANSSI-FR/ORADAD
- Microsoft, script de réinitialisation du compte krbtgt : github.com/microsoft/New-KrbtgtKeys.ps1
- Microsoft Sysinternals, Autoruns : learn.microsoft.com
- MITRE ATT&CK, techniques de persistance citées (T1574.006, T1556.003, T1098.004, T1546.003, T1505.003…) : attack.mitre.org
- Velociraptor : docs.velociraptor.app ; LOKI : github.com/Neo23x0/Loki